Kurzfassung — aktualisiert am 1. Oktober 2026
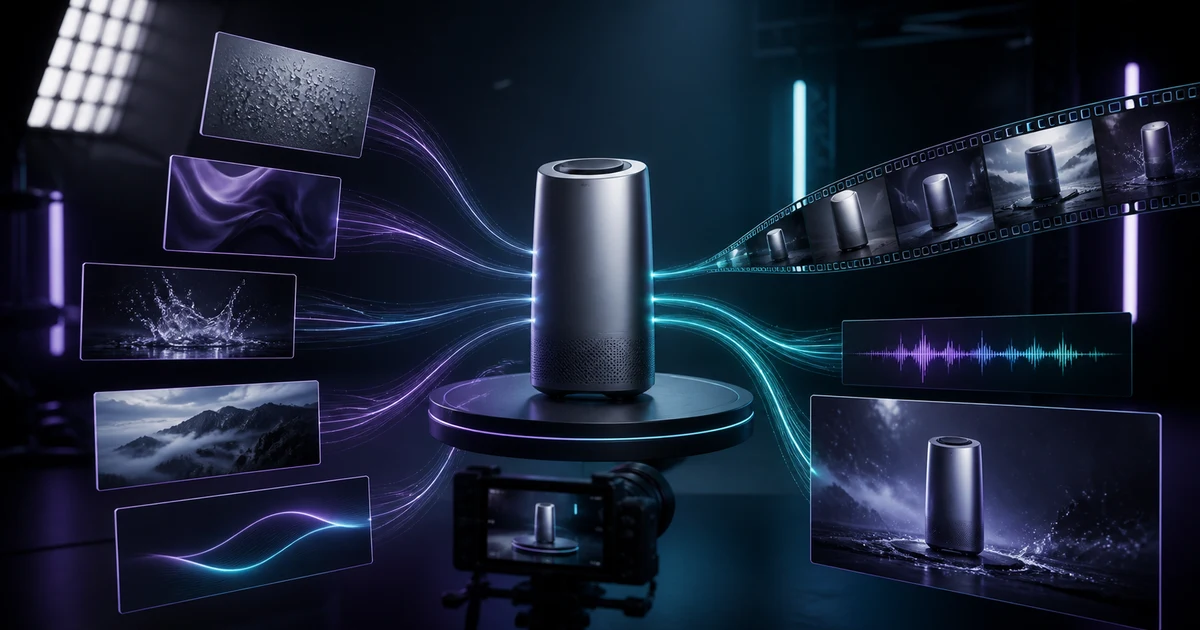
MiniMax H3 ist ein Open-Weight-omni-modales Modell, das Video mit nativem Stereo-Audio in einem einzigen Durchlauf erzeugt — bis zu 15 Sekunden bei 2K-Auflösung. Auf v4v läuft es in drei Modi: Text-zu-Video mit nativem Audio, Bildanimation mit Steuerung für erstes/letztes Bild und referenzgesteuerte Generierung, die bis zu 9 Bilder, 3 Videoclips und 3 Audiospuren in einem Kontextfenster akzeptiert. Dieser letzte Modus ist das eigentliche Unterscheidungsmerkmal für Produktanzeigen. Statt dein Produkt in einem Prompt zu beschreiben, zeigst du dem Modell genau, wie es aussieht. Das Ergebnis ist konsistente, markengerechte Creative ohne Filmteam. Credits auf v4v beginnen bei 7 $ für 1.000. Eine 8-Sekunden-Ausgabe verbraucht 64 Credits bei 768P oder 104 Credits bei 2K, vor zusätzlichen Gebühren für weitere Bilder, und Paket-Credits verfallen nie.
Was unterscheidet MiniMax H3 von früheren Videomodellen?
Die meisten Modelle zur Videogenerierung arbeiten sequenziell. Du generierst das Video, fügst Audio separat hinzu und verbringst dann Zeit damit, die Abweichungen zwischen beiden zu korrigieren. MiniMax H3 wurde anders entwickelt.
Es ist ein Open-Weight-Allzweck-omni-modales Modell, das Video, Audio und Sprache von Anfang an als einheitlichen Kontext behandelt. Laut der eigenen H3-Ankündigung von MiniMax erzeugt das Modell natives Stereo-Audio zusammen mit dem Video — auf Frame-Ebene synchronisiert — statt Ton erst nachträglich darüberzulegen. Für Produktanzeigen bedeutet das Voice-over, Umgebungsgeräusche oder Produktsound, die tatsächlich zu dem passen, was auf dem Bildschirm passiert, ohne manuelle Bearbeitung.
Die Auflösung reicht bis 2K, und Clips laufen bis zu 15 Sekunden. Das deckt jedes wichtige Short-Form-Anzeigenformat ab, vom 6-Sekunden-Bumper bis zum 15-Sekunden-TikTok oder Reel.
Die Architektur mit einheitlichem Kontext bedeutet auch, dass das Modell mehrere Referenzeingaben gleichzeitig hält, statt sie nacheinander zu verarbeiten. Das ist die Grundlage für den referenzgesteuerten Modus — und der Grund, warum er konsistentere Ergebnisse liefert als Modelle, die Referenzen sequenziell verarbeiten, wie die Aufschlüsselung der H3-Architektur von scenario.com erklärt.
Was sind die drei MiniMax-H3-Modi auf v4v?
Modus 1: Text zu Video mit nativem Audio
Du schreibst einen Prompt. Das Modell erzeugt Video und Audio zusammen in einem Durchlauf. Kein separater Audio-Schritt, keine Bearbeitung in der Timeline.
Dieser Modus eignet sich gut für Konzeptanzeigen, wenn du noch keine bestehenden Produktbilder hast, oder für die Generierung von Hintergrundmaterial mit Umgebungsgeräuschen. Voice-over, Musikuntermalung und Sounddesign entstehen alle in einem einzigen Generierungsjob.
Für einen DTC-Betreiber, der schnell eine Variante eines Kampagnenkonzepts braucht, ist das der schnellste Weg von der Idee zu einem anschaubaren Clip.
Modus 2: Bildanimation mit Steuerung für erstes und letztes Bild
Du stellst ein Produktbild bereit und das Modell animiert es. Die Option für erstes/letztes Bild lässt dich den Start- und Endzustand der Bewegung definieren, sodass die Animation einem vorhersehbaren Bewegungsbogen folgt, statt zufällige Bewegung zu erzeugen.
Diese Steuerung ist speziell für Produktanzeigen wichtig. Eine Hautpflegeflasche, die sich um 90 Grad dreht und mit dem Etikett nach vorn landet, ist eine wiederholbare, kontrollierte Bewegung. Ohne Eingaben für erstes/letztes Bild neigen Animationsmodelle zu unvorhersehbarem Kameradrift oder Objektverformung. Die Steuereingaben begrenzen das.
Die Ausgabe enthält weiterhin natives Audio, sodass du die Animation in derselben Generierung mit einem Sprechertext-Prompt oder Umgebungsgeräuschen kombinieren kannst.
Modus 3: Referenzgesteuerte Generierung
Dieser Modus hebt MiniMax H3 von den meisten Alternativen ab. Im Referenz-zu-Video-Modus von H3 kannst du bis zu 9 Referenzbilder, 3 Videoclips und 3 Audiospuren in ein einziges Kontextfenster geben — und das Modell nutzt sie alle gleichzeitig, um die Ausgabe zu steuern.
In der Praxis bedeutet das, dass du dem Modell gleichzeitig deine Produktaufnahmen, eine Bewegungsreferenz und ein Audio-Cue deiner Marke gibst. Das Modell synthetisiert über alle drei Eingabetypen hinweg, statt sie als getrennte Anweisungen auszuführen. Das Ergebnis ist im Vergleich zu Modellen, die Referenzen nacheinander verarbeiten, ein deutlich konsistenteres Erscheinungsbild von Charakteren und Objekten über alle Frames hinweg.
Für Produktwerbung ist die Konsequenz direkt: Dein Produkt sieht in der Ausgabe wie dein Produkt aus, nicht wie eine plausible Annäherung daran. Genau diese Lücke schließt die referenzgesteuerte Generierung.
Warum ist referenzgesteuerte Generierung wichtiger als Prompt Engineering?
Prompt Engineering für visuelle Konsistenz ist ein Workaround, keine Lösung. Du kannst Farbe, Form und Material eines Produkts in präziser Sprache beschreiben — das Modell interpretiert trotzdem Text. Zwei Prompts, die dasselbe Produkt beschreiben, erzeugen zwei unterschiedlich aussehende Produkte.
Referenzbilder entfernen den Interpretationsschritt vollständig. Das Modell sieht das Objekt. Es muss es sich nicht anhand einer Beschreibung vorstellen.
Das Limit von 9 Bildeingaben in H3 ist hier entscheidend. Du kannst mehrere Produktwinkel, Farbvarianten und Lichtbedingungen in einem einzigen Kontext abdecken. Das Modell baut eine reichhaltigere interne Repräsentation des Objekts auf, als es mit einem Referenzbild oder einem beliebigen Text-Prompt möglich wäre.
Deshalb ist referenzgesteuerte Generierung die Standardempfehlung für jede Produktanzeige, bei der Markenkonsistenz wichtig ist. Stil, Bewegung und Audio folgen alle demselben Prinzip: Zeig dem Modell, was du willst. Beschreibe es nicht.
Verwandle deine Produktseite in unter 5 Minuten in ein Video →
Wie funktioniert die Credit-Bepreisung von v4v für MiniMax H3?
v4v verwendet ein Credit-Pack-System. Keine Abos. Du kaufst Credits, nutzt sie, und sie verfallen nie.
Packs beginnen bei 7 $ für 1.000 Credits. MiniMax H3 verwendet 8 Credits pro Sekunde bei 768P oder 13 Credits pro Sekunde bei 2K. Die Dauer des Eingabevideos wird zum gleichen Auflösungs-Satz berechnet; Audioeingabe ist kostenlos. Die ersten fünf Referenzbilder sind kostenlos, und jedes zusätzliche Bild verbraucht 4 Credits. Dein Guthaben gilt für alle v4v-Modelle, daher erfordert das Testen von H3 gegenüber Seedance 2.0 oder Wan 2.7 keinen separaten Plan.
Diese Struktur macht Creative-Testing vorhersehbar. Eine 8-sekündige Generierung verbraucht 64 Credits bei 768P (etwa 0,45 $ zum Einstiegspack-Satz) oder 104 Credits bei 2K (etwa 0,73 $), vor Gebühren für Referenzbilder über die ersten fünf hinaus.
Die aktuellen Pack-Optionen findest du unter v4v.ai/prices.
Wie passt MiniMax H3 in eine Produktanzeigen-Produktions-Pipeline?
Eine typische Produktanzeigen-Pipeline mit H3 auf v4v sieht so aus:
- Referenz-Medien beschaffen. Ziehe 4–9 Produktbilder mit unterschiedlichen Winkeln und Lichtbedingungen heran. Füge vorhandene Markenvideoclips oder Audiohinweise hinzu, falls verfügbar.
- Deinen Modus wählen. Referenzgeführte Generierung für markenkonsistente Produktanzeigen. Bildanimation für Formate mit einer einzelnen Hero-Aufnahme. Text-zu-nativem-Audio für Konzept- oder Lifestyle-Footage.
- Erstes/letztes Frame festlegen, wenn du Bildanimation verwendest. Definiere Start- und Endzustände, um den Bewegungsbogen zu steuern.
- Generieren und prüfen. Ein 8-sekündiges Ergebnis verbraucht 64 Credits bei 768P oder 104 Credits bei 2K, vor eventuellen Gebühren für zusätzliche Bilder. Prüfe Produktgenauigkeit und Audio-Sync.
- Beim Referenzsatz iterieren. Wenn das Ergebnis vom Erscheinungsbild des Produkts abweicht, füge mehr Referenzwinkel hinzu, statt den Prompt umzuschreiben.
Die Iterationsschleife ist schneller als traditionelle Produktion, weil die Variable der Referenzsatz ist, nicht ein Filmsetup. Das Austauschen eines Referenzbilds dauert Sekunden.
Ein Merchant-Test, der auf r/ecommerce geteilt wurde (Juli 2026), ergab, dass Produktseiten mit 8–10-sekündigen Demo-Videos ungefähr 12 % höher konvertierten. Das ist das Ergebnis eines einzelnen Shops, keine Branchenstudie — aber es zeigt, warum es sich lohnt, auf ein konsistentes, präzises Produktvideo hinzuarbeiten.
Kannst du MiniMax H3 mit der v4v Shopify-App verwenden?
Die v4v Shopify App ist live im Shopify App Store: Wähle ein Produkt im Shopify-Admin aus, sieh dir den Clip in der Vorschau an und veröffentliche ihn auf der Produktseite. Drei Videos gratis bei der Installation.
Für Betreiber mit großen Katalogen ist dieser Schritt nicht trivial. 50 Produktvideos zu generieren und jedes davon manuell hochzuladen, fügt einem Prozess, der Minuten dauern sollte, Stunden hinzu.
Wofür solltest du MiniMax H3 in Produktanzeigen tatsächlich verwenden?
Die stärksten Einsatzfälle, basierend auf der H3-Architektur:
- Hero-Produktaufnahmen mit kontrollierter Bewegung. Bildanimation plus Steuerung von erstem/letztem Frame. Ein Referenzbild, definierte Start- und Endposition, native Audionarration.
- Produktpräsentationen aus mehreren Winkeln. Referenzgeführte Generierung mit 6–9 Bildern, die das gesamte Produkt abdecken. Das Modell hält das Erscheinungsbild des Produkts über den Clip hinweg konsistent.
- Stilabgestimmte Kampagnenvarianten. Gib eine Video-Referenz des Kampagnenstils, den du angleichen möchtest, plus deine Produktbilder vor. Das Modell wendet die Bewegungs- und visuelle Stilistik auf dein Produkt an.
- Audio-synchronisierte Produktdemos. Text-zu-Native-Audio-Modus für Demos, bei denen die Vertonung exakt zur Handlung passen muss. Keine Audiosynchronisation in der Postproduktion erforderlich.
Der Modus, den du bei markenkritischen Produktanzeigen vermeiden solltest, ist ungebundenes Text-zu-Video ohne Referenzbilder. Prompts allein reproduzieren das Erscheinungsbild eines bestimmten Produkts nicht zuverlässig. Nutze Referenzen. Wenn du H3s Umgang mit Referenzen mit einem anderen Generierungsansatz vergleichen möchtest, Nano-banana 2 ist einen direkten Vergleich wert.
Das Prinzip, das in allen drei Modi gilt:
Referenzeingaben sind Textbeschreibungen immer überlegen, wenn visuelle Genauigkeit zählt. Bei Produktanzeigen ist visuelle Genauigkeit nicht optional. Sie ist der Unterschied zwischen einer Anzeige, die Vertrauen schafft, und einer, die wie eine plausible Version deines Produkts aussieht.
MiniMax H3s einheitliche Kontextarchitektur macht die Generierung mit mehreren Referenzen auf diesem Kostenniveau erstmals praktikabel. Nutze das. Reine Prompt-Generierung ist ein Fallback, keine Strategie.
Entdecke unter, was MiniMax H3 für deine Produktanzeigen leisten kann v4v.ai.
Füge einen Produktlink ein. Das Briefing erstellt sich selbst.
Erstelle Produktvideos, UGC-Style-Anzeigen und Hooks in etwa 5 Minuten.
Ab 7 $ · kein Abonnement erforderlich · Paket-Credits verfallen nie
FAQs
Was ist MiniMax H3?
MiniMax H3 ist ein omni-modales KI-Modell mit offenen Gewichten für allgemeine Zwecke, das Video mit nativem Stereo-Audio in einem einzigen Durchlauf generiert. Es unterstützt Clips bis zu 15 Sekunden in 2K-Auflösung und akzeptiert gleichzeitig Text-, Bild-, Video- und Audioeingaben.
Was bedeutet „natives Audio“ in MiniMax H3?
Das Modell generiert Audio und Video zusammen in einem einzigen Durchlauf, auf Frame-Ebene synchronisiert. Es handelt sich nicht um eine separate Spur, die nach der Videogenerierung hinzugefügt wird. Das Ergebnis ist Audio, das ohne manuelle Bearbeitung zur Handlung auf dem Bildschirm passt.
Wie viele Referenzeingaben akzeptiert MiniMax H3?
Bis zu 9 Referenzbilder, 3 Videoclips und 3 Audiospuren in einem einzigen Kontextfenster. Alle Eingaben werden gleichzeitig verarbeitet, nicht nacheinander.
Wie viel kostet es, mit MiniMax H3 auf v4v ein Video zu generieren?
MiniMax H3 verwendet 8 Credits pro Sekunde bei 768P oder 13 Credits pro Sekunde bei 2K. Für die Dauer von Eingabevideos gilt derselbe Satz, Audioeingaben sind kostenlos, die ersten fünf Referenzbilder sind kostenlos und jedes zusätzliche Bild kostet 4 Credits. Packs beginnen bei 7 $ für 1.000 Credits und verfallen nie.
Was ist der Unterschied zwischen Bildanimation und referenzgesteuerter Generierung in H3?
Bildanimation nimmt ein einzelnes Bild und animiert es, mit optionaler Steuerung für erstes/letztes Bild, um den Bewegungsbogen festzulegen. Referenzgesteuerte Generierung akzeptiert bis zu 9 Bilder, 3 Videos und 3 Audiospuren, um die gesamte Ausgabe zu steuern — und liefert so konsistentere Ergebnisse für komplexe Produktanzeigen oder Anzeigen mit mehreren Blickwinkeln.