摘要——更新于 2026 年 10 月 1 日
MiniMax H3 是一款开源权重的全模态模型,可在单次生成中同时产出带原生立体声音频的视频——最长 15 秒,分辨率最高 2K。在 v4v 上,它提供三种模式:文生原生音频视频、带首帧/末帧控制的图像动画,以及参考引导生成,后者可在单个上下文窗口中接受最多 9 张图片、3 段视频片段和 3 条音轨。最后这一模式,才是它在产品广告场景中的真正差异化所在。你无需在提示词里描述产品,只要直接让模型看到产品长什么样。结果就是:无需拍摄团队,也能产出一致、符合品牌调性的创意内容。v4v 点数 1,000 点起价 7 美元。8 秒输出在 768P 下消耗 64 点数,在 2K 下消耗 104 点数,且均未包含额外图片费用;购买的点数包永不过期。
MiniMax H3 与早期视频模型有何不同?
大多数视频生成模型按顺序工作:先生成视频,再单独添加音频,然后还要花时间修正两者之间的不匹配。MiniMax H3 的构建方式不同。
它是一款开源权重、通用型的全模态模型,从一开始就将视频、音频和语言视为统一上下文。根据 MiniMax 自己发布的 H3 公告,该模型会在生成视频的同时生成原生立体声音频——并在帧级实现同步——而不是事后再把声音叠加上去。对于产品广告来说,这意味着配音、环境音或产品音效能真正与画面内容匹配,无需手动剪辑。
分辨率最高可达 2K,片段时长最长 15 秒。这已覆盖所有主流短广告格式,从 6 秒 bumper 到 15 秒的 TikTok 或 Reel。
这种统一上下文架构也意味着,模型会同时保留多个参考输入,而不是逐个处理。这正是参考引导模式的基础——也是它比按顺序处理参考素材的模型更稳定一致的原因,scenario.com 对 H3 架构的解析对此有说明。
v4v 上的 MiniMax H3 三种模式是什么?
模式 1:文生原生音频视频
你写一个提示词,模型便会在一次生成中同时产出视频和音频。无需单独处理音频,也无需时间轴剪辑。
这种模式很适合没有现成产品素材的概念广告,或用于生成带环境音的背景画面。旁白、音乐底和声音设计都来自同一次生成任务。
对于需要快速产出营销概念变体的 DTC 团队来说,这是从想法到可观看片段的最快路径。
模式 2:带首帧和末帧控制的图像动画
你提供一张产品图,模型会将其做成动画。首帧/末帧选项让你定义运动的起始和结束状态,因此动画会沿着可预测的轨迹运动,而不是产生随机移动。
这种控制对产品广告尤其重要。比如,一瓶护肤品旋转 90 度,最后以标签正对镜头的姿态停住,这是可复现、可控的运动。没有首帧/末帧输入时,动画模型往往会出现难以预测的镜头漂移或物体形变。而这些控制输入会对结果形成约束。
输出依然包含原生音频,因此你可以在同一次生成中,将动画与旁白提示词或环境音搭配起来。
模式 3:参考引导生成
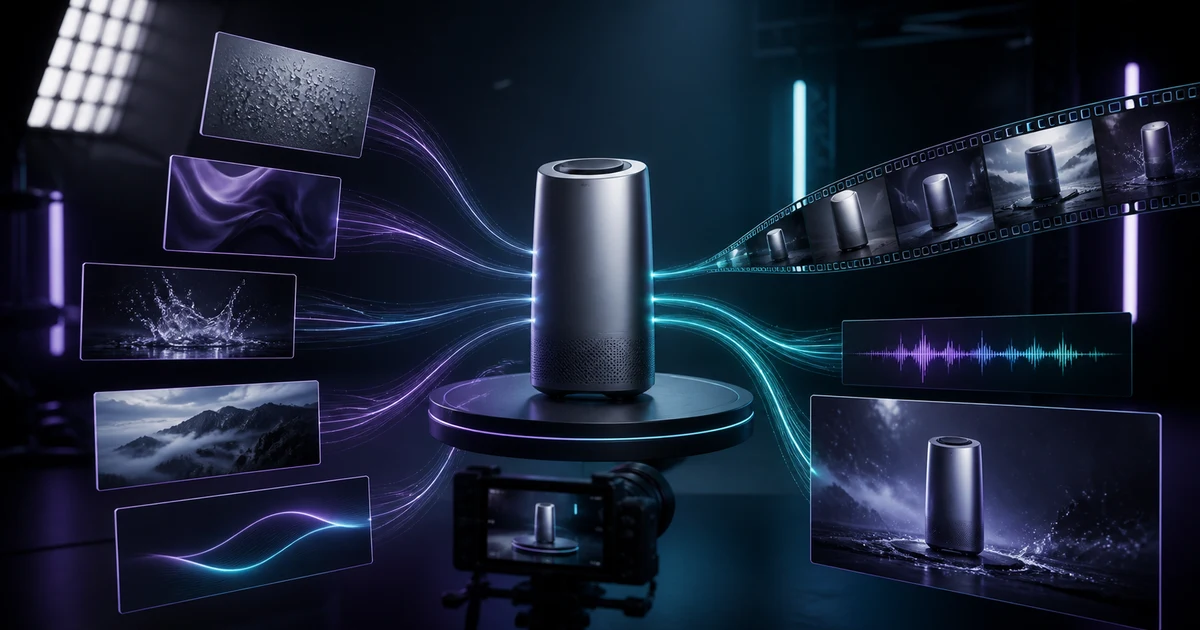
这是 MiniMax H3 区别于大多数替代方案的模式。在 H3 的参考转视频模式中,你可以将最多 9 张参考图片、3 段视频片段和 3 条音轨传入单个上下文窗口——模型会同时使用它们来引导输出。
在实际使用中,这意味着你可以同时把产品拍摄图、运动参考和品牌音频提示交给模型。模型会综合这三类输入进行生成,而不是把它们当作彼此独立的指令来依次处理。与逐个处理参考素材的模型相比,最终结果在跨帧的人物和物体外观一致性上会显著更好。
对于产品广告,这一点的意义非常直接:输出中的产品看起来就是你的产品,而不是一个看似合理的近似版本。参考引导生成弥补的,正是这道差距。
为什么参考引导生成比提示词工程更重要?
用提示词工程来实现视觉一致性,本质上是一种权宜之计,而非真正的解决方案。你可以用非常精确的语言描述产品的颜色、形状和材质——但模型依然是在解读文本。同样的产品,用两段提示词描述,生成出来也可能长得不一样。
参考图片则完全去掉了解读这一步。模型能直接看到这个物体,不需要根据描述去想象它。
H3 的 9 图输入上限在这里很有意义。你可以在同一个上下文中覆盖产品的多个角度、不同配色和不同布光条件。相比只给 1 张参考图,或只用文字提示,模型能建立起对该物体更丰富的内部表征。
这就是为什么,只要是重视品牌一致性的产品广告,默认都建议使用参考引导生成。风格、运动和音频都遵循同一个原则:把你想要的东西展示给模型看,而不是描述给它听。
v4v 上 MiniMax H3 的点数计费如何运作?
v4v 使用点数包系统。无订阅。你购买点数、使用点数,而且点数永不过期。
点数包 7 美元起,可购买 1,000 点数。MiniMax H3 在 768P 下每秒消耗 8 点数,在 2K 下每秒消耗 13 点数。输入视频时长按相同分辨率费率计费;音频输入免费。前 5 张参考图免费,此后每增加 1 张图片消耗 4 点数。你的余额可在所有 v4v 模型间通用,因此将 H3 与 Seedance 2.0 或 Wan 2.7 进行测试无需单独购买方案。
这种结构让创意测试的成本更可预测。一段 8 秒生成在 768P 下消耗 64 点数(按入门点数包费率约为 0.45 美元),在 2K 下消耗 104 点数(约为 0.73 美元),这还不包括超出前 5 张后的参考图费用。
当前点数包选项请见 v4v.ai/prices.
MiniMax H3 如何融入产品广告生产流程?
在 v4v 上使用 H3 的典型产品广告流程如下:
- 准备参考素材。 整理 4–9 张覆盖不同角度和光线条件的产品图片。如有现成的品牌视频片段或音频提示,也可一并加入。
- 选择模式。 参考引导生成适用于保持品牌一致性的产品广告。图片动画适用于单一主打镜头形式。原生音频文生视频适用于概念型或生活方式类画面。
- 如果使用图片动画,请设置首帧/末帧。 定义起始和结束状态,以控制运动轨迹。
- 生成并审核。 一段 8 秒输出在 768P 下消耗 64 点数,在 2K 下消耗 104 点数,未包含任何额外图片费用。请检查产品准确性和音频同步。
- 迭代参考素材集。 如果输出偏离产品外观,应增加更多参考角度,而不是重写提示词。
这种迭代循环比传统制作更快,因为变量是参考素材集,而不是拍摄布置。替换一张参考图只需几秒。
2026 年 7 月,r/ecommerce 上分享的一项商家测试发现,带有 8–10 秒演示视频的产品页面,转化率约高出 12%。这只是单个店铺的结果,并非行业研究——但它说明了为什么值得不断迭代,以获得稳定且准确的产品视频。
你可以在 v4v Shopify 应用中使用 MiniMax H3 吗?
v4v Shopify 应用现已上线 Shopify App Store: 在 Shopify 后台选择产品、预览片段,然后发布到产品页面。安装即送 3 条免费视频。
对于运营大型商品目录的操作者来说,这一步并不简单。生成 50 条产品视频,再逐条手动上传,会给本应只需几分钟的流程额外增加数小时。
在产品广告中,你究竟应该如何使用 MiniMax H3?
基于 H3 的架构,最强的用例如下:
- 受控运动的主打产品镜头。 图片动画加首帧/末帧控制。一张参考图、明确的起始与结束位置、原生音频旁白。
- 多角度产品展示。 使用 6–9 张覆盖完整产品的图片进行参考引导生成。模型可在整个片段中保持产品外观一致。
- 风格匹配的广告活动变体。 输入一段你想匹配其广告活动风格的视频参考,再加上你的产品图片。模型会将该运动与视觉风格应用到你的产品上。
- 音频同步的产品演示。 适用于演示场景的文生原生音频模式,可让旁白与画面动作精准匹配。无需后期做音画同步。
对于对品牌要求极高的产品广告,应避免使用不带参考图的无约束文生视频模式。仅靠提示词并不能稳定复现某个特定产品的外观。请使用参考图。如果你想将 H3 的参考处理能力与另一种生成方式进行对比, Nano-banana 2 值得并排测试。
适用于这三种模式的共同原则
只要视觉准确性重要,参考输入就始终优于文字描述。对于产品广告来说,视觉准确性不是可有可无的。它决定了一支广告是在建立信任,还是看起来只是你产品的一个似是而非的版本。
MiniMax H3 的统一上下文架构首次让多参考生成在这一成本水平上具备了实用性。用起来。仅靠提示词生成只是备选方案,不是策略。
前往了解 MiniMax H3 能为你的产品广告带来什么: v4v.ai.
常见问题
什么是 MiniMax H3?
MiniMax H3 是一款开放权重、通用型全模态 AI 模型,可在单次生成中输出带原生立体声音频的视频。它支持最长 15 秒、2K 分辨率的片段,并可同时接受文本、图片、视频和音频输入。
MiniMax H3 中的“原生音频”是什么意思?
该模型会在一次生成过程中同时生成音频和视频,并在帧级别保持同步。它不是在视频生成后再额外添加的一条音轨。结果就是音频能与屏幕上的动作匹配,无需手动剪辑。
MiniMax H3 接受多少个参考输入?
单个上下文窗口内最多支持 9 张参考图、3 段视频片段和 3 条音轨。所有输入都会同时处理,而不是按顺序处理。
在 v4v 上用 MiniMax H3 生成视频要花多少钱?
MiniMax H3 在 768P 下每秒消耗 8 点,在 2K 下每秒消耗 13 点。输入视频时长按相同费率计算,音频输入免费,前 5 张参考图免费,每增加 1 张图片消耗 4 点。点数包 1,000 点起售价为 7 美元,且永不过期。
H3 中的图像动画和参考引导生成有什么区别?
图像动画会基于单张图片生成动画,并可选用首帧/末帧控制来定义运动轨迹。参考引导生成最多可接受 9 张图片、3 段视频和 3 条音轨来共同引导整个输出——对于复杂或多角度的产品广告,能产出更一致的结果。